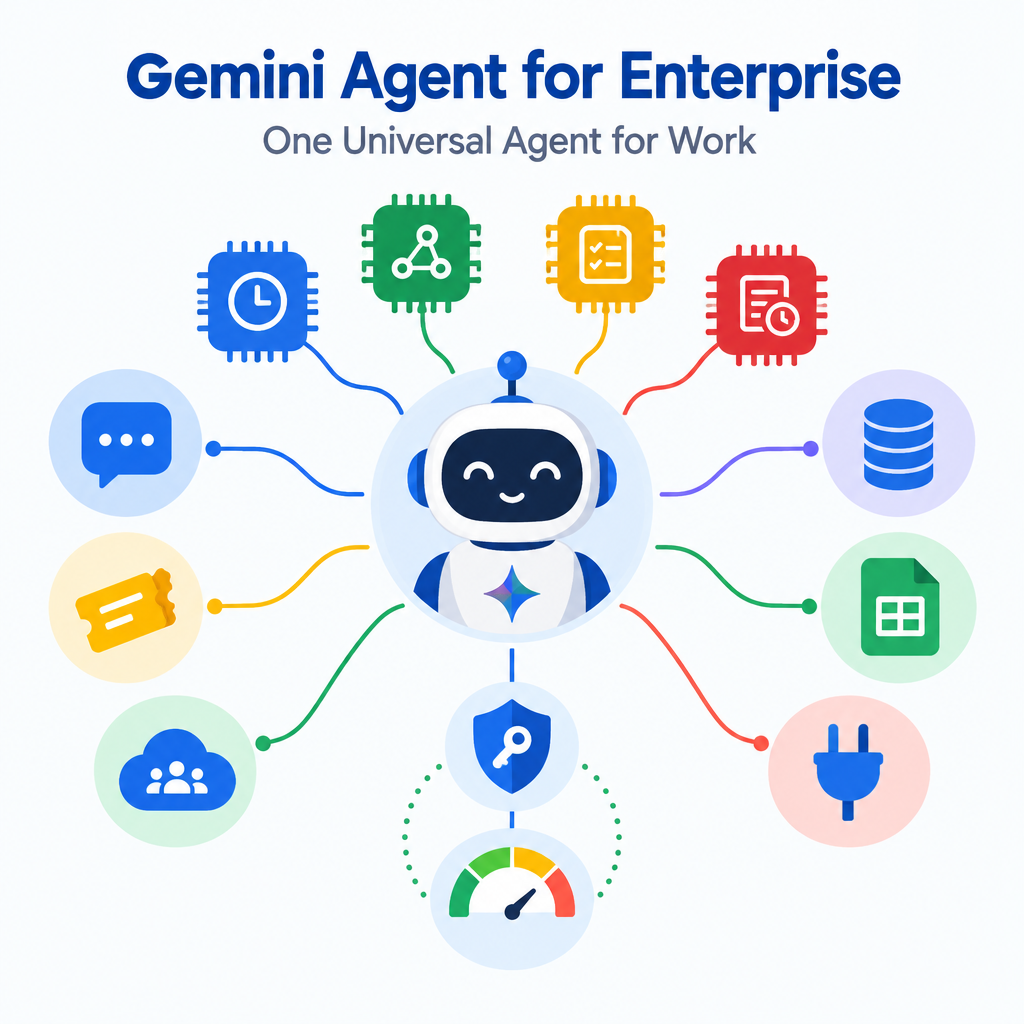
기업의 AI 활용 방식이 단순한 질의응답을 넘어 실제 업무를 수행하는 방향으로 발전하고 있습니다. 이제 AI는 질문에 답하거나 문서를 요약하는 수준을 넘어, 기업 내부 데이터를 활용하고 여러 도구를 연결해 복잡한 작업을 계획하고 실행하는 역할을 맡기 시작했습니다.
이러한 흐름에 맞춰 Google Cloud는 2026년 10월 8일, 기업 업무 전반을 지원하는 통합형 AI 에이전트인 Google Cloud Gemini 에이전트를 발표했습니다. 하나의 인터페이스와 API를 통해 지식 업무, 질문 응답, 콘텐츠 생성, 코드 작성 및 실행 등을 지원하며, 여러 AI 모델과 기업 시스템을 연계해 작업을 수행하는 것이 특징입니다.
이번 글에서는 Google Cloud Gemini 에이전트의 핵심 개념과 아키텍처, 메모리 구조, 멀티 에이전트 기능, 데이터 분석 지원 방식, 보안 및 비용 관리 기능을 살펴봅니다. 또한 기존의 대화형 AI와 어떤 차이가 있는지, 기업 환경에서 어떤 활용 가능성을 기대할 수 있는지도 함께 정리합니다.
1. Google Cloud Gemini 에이전트란?
Google Cloud Gemini 에이전트는 기업의 다양한 업무를 하나의 통합된 환경에서 처리하도록 설계된 클라우드 기반 AI 에이전트입니다.
일반적인 챗봇이 사용자의 질문에 답변하는 데 초점을 맞춘다면, Gemini 에이전트는 사용자가 달성하려는 목표를 이해하고 필요한 작업을 계획한 뒤, 적절한 도구와 기업 시스템을 활용해 결과물을 만드는 데 초점을 맞춥니다.
예를 들어 사용자가 데이터 분석을 요청하면 단순히 분석 방법을 설명하는 데 그치지 않고, 관련 데이터에 접근하고 필요한 코드를 작성하거나 분석 작업을 실행하는 방식으로 업무를 지원할 수 있습니다.
Google Cloud가 제시한 핵심 방향은 여러 개의 개별 AI 도구를 따로 사용하는 대신, 하나의 에이전트를 중심으로 다양한 업무를 처리하는 것입니다.
1.1. 하나의 인터페이스에서 다양한 업무 처리
Gemini 에이전트는 단일 프롬프트 인터페이스와 API를 통해 다음과 같은 업무를 지원합니다.
- 질문 응답: 기업 데이터와 업무 맥락을 바탕으로 필요한 정보를 제공
- 지식 업무: 문서와 기업 정보를 활용해 업무 결과물 생성
- 콘텐츠 제작: 생성형 AI를 활용한 미디어 및 콘텐츠 생성
- 코드 작성 및 실행: 개발 업무에 필요한 코드 생성과 실행 지원
- 업무 자동화: 목표에 따라 작업을 계획하고 도구를 활용해 단계적으로 수행
이러한 통합 구조는 업무마다 서로 다른 AI 서비스를 선택하고 데이터를 옮겨야 하는 번거로움을 줄일 수 있습니다.
특히 기업에서 AI를 도입할 때는 모델의 성능뿐 아니라 기존 업무 시스템과의 연결, 작업 이력 관리, 사용자 권한 통제도 중요합니다. Gemini 에이전트는 이러한 요소를 하나의 업무 실행 환경으로 통합하려는 접근을 보여줍니다.
1.2. 단순한 챗봇을 넘어선 업무 위임 방식
Gemini 에이전트의 중요한 특징은 사용자가 세부적인 실행 절차를 일일이 지정하기보다 달성해야 할 목표를 전달하는 방식에 있습니다.
일반적인 대화형 AI에서는 사용자가 필요한 단계를 하나씩 요청하는 경우가 많습니다. 반면 에이전트는 주어진 목표에 따라 작업을 계획하고, 필요한 기능과 도구를 선택하며, 여러 단계를 연결해 결과를 도출하도록 설계됩니다.
이러한 방식은 작업의 복잡도가 높아질수록 의미가 커집니다. 여러 문서를 검토하거나 데이터를 분석하고, 분석 결과를 정리하는 것처럼 여러 단계가 필요한 업무를 하나의 목표로 묶어 처리할 수 있기 때문입니다.
다만 실제 업무의 성공 여부는 연결된 시스템의 권한, 데이터 품질, 사용 가능한 도구, 에이전트의 실행 결과에 따라 달라질 수 있습니다.
2. Google Cloud Gemini 에이전트의 핵심 아키텍처
Google Cloud는 Gemini 에이전트의 설계 방향으로 여섯 가지 핵심 원칙을 제시했습니다.
2.1. 통합형 에이전트
첫 번째는 대화, 자율적인 목표 수행, 코드 생성을 하나의 인터페이스에서 지원하는 구조입니다.
사용자는 업무마다 별도의 AI 도구를 선택하기보다 동일한 환경에서 질문하고, 콘텐츠를 만들고, 코드를 작성하는 작업을 요청할 수 있습니다.
이러한 통합은 여러 AI 서비스 사이에서 발생하는 작업 전환을 줄이고 업무 흐름을 단순화하는 데 도움이 될 수 있습니다.
2.2. 다양한 환경에서의 접근성
두 번째는 여러 기기와 업무 환경에서 에이전트를 사용할 수 있도록 하는 것입니다.
원문에서는 웹, 모바일, 데스크톱, 명령줄 인터페이스(CLI)를 비롯해 Google Workspace, Microsoft 365, Slack 등의 환경을 통한 접근을 소개합니다. 또한 다른 애플리케이션에 에이전트 기능을 통합하는 방식도 지원 대상으로 제시합니다.
이는 AI 에이전트를 별도의 도구로만 사용하는 것이 아니라, 사용자가 기존에 업무를 처리하는 환경 안에서 활용할 수 있도록 하는 접근입니다.
2.3. 클라우드 기반의 지속적인 실행
세 번째는 작업이 클라우드에서 지속적으로 실행될 수 있다는 점입니다.
일반적인 대화형 AI는 사용자가 요청을 입력하고 응답을 확인하는 상호작용에 초점을 맞춥니다. 반면 Gemini 에이전트는 장시간이 필요한 작업도 클라우드에서 이어서 수행할 수 있도록 설계됐습니다.
원문에서는 작업이 몇 시간에서 며칠까지 이어질 수 있으며, 사용자가 노트북을 닫더라도 실행이 지속될 수 있다고 설명합니다.
이러한 구조는 여러 단계의 분석이나 장시간의 처리 과정이 필요한 업무에 유용할 수 있습니다. 작업 도중 사용자의 접속이 끊기더라도 실행 환경을 유지할 수 있기 때문입니다.
2.4. 멀티 에이전트 오케스트레이션
네 번째는 여러 하위 에이전트를 활용해 작업을 분담하는 기능입니다.
Gemini 에이전트는 작업의 성격에 따라 하위 에이전트를 구성하고, 각 작업을 병렬 또는 순차적으로 실행할 수 있도록 설계됐습니다.
예를 들어 기업의 데이터 분석 업무를 가정하면 다음과 같이 작업을 나눌 수 있습니다.
- 필요한 데이터와 관련 문서를 확인합니다.
- 데이터를 분석하는 작업을 수행합니다.
- 분석 결과를 검토하고 핵심 내용을 정리합니다.
- 최종 보고서를 생성합니다.
이는 기능을 설명하기 위한 예시이며, 실제 작업 분배 방식은 요청 내용과 연결된 도구에 따라 달라질 수 있습니다.
여러 작업을 동시에 수행할 수 있다면 전체 처리 시간을 줄일 가능성이 있습니다. 반대로 작업 사이에 의존 관계가 있다면 먼저 완료해야 하는 단계부터 순차적으로 진행해야 합니다.
2.5. 업무 맥락을 활용하는 구조
다섯 번째는 기업의 도구, 데이터, 업무 이력을 활용해 맥락을 유지하는 기능입니다.
기업 업무에서는 같은 용어라도 부서에 따라 의미가 다를 수 있으며, 동일한 작업도 조직마다 처리 절차가 다를 수 있습니다.
따라서 AI가 일반적인 지식만으로 답변하는 것보다 기업 내부의 문서, 업무 규칙, 데이터 정의 등을 함께 활용하는 것이 중요합니다.
Gemini 에이전트는 이러한 업무 맥락을 메모리와 기업 시스템 연결을 통해 활용하도록 설계됐습니다.
2.6. 작업에 맞는 AI 모델 선택
여섯 번째는 작업의 특성에 따라 적합한 AI 모델을 선택하는 구조입니다.
모든 업무에 동일한 모델을 사용하는 대신, 복잡한 추론이 필요한 작업과 빠른 응답이 중요한 작업, 미디어 생성이 필요한 작업 등에 적합한 모델을 활용하는 방식입니다.
이를 통해 성능과 응답 속도, 비용 사이의 균형을 맞출 수 있습니다.
원문은 Gemini 계열 모델과 Anthropic의 Claude 모델을 활용한 오케스트레이션을 소개하며, 추가적인 비공개 모델과 오픈 모델의 활용도 계획으로 언급합니다. 구체적인 모델 구성과 제공 범위는 실제 서비스 정책에 따라 확인할 필요가 있습니다.
3. Gemini 에이전트의 메모리 구조
AI 에이전트가 복잡한 업무를 수행하려면 현재 요청뿐 아니라 관련 정보와 이전 작업의 맥락도 활용할 수 있어야 합니다.
Gemini 에이전트는 이러한 목적을 위해 네 가지 유형의 메모리를 활용하는 구조를 제시합니다.
3.1. 세션 메모리(Session Memory)
세션 메모리는 현재 진행 중인 작업과 관련된 정보를 유지하는 역할을 합니다.
작업이 여러 단계로 구성되거나 며칠에 걸쳐 진행되는 경우에도 현재 작업의 맥락을 이어가는 데 활용됩니다.
예를 들어 여러 문서를 비교하고 결과를 종합하는 업무에서는 앞서 확인한 내용과 현재 진행 상황을 유지하는 것이 중요합니다. 세션 메모리는 이러한 작업 연속성을 지원하기 위한 구성 요소입니다.
3.2. 의미 메모리(Semantic Memory)
의미 메모리는 문서와 사람 등에 관한 정보를 구조화된 지식 기반으로 구성하는 역할을 합니다.
기업 내부에는 업무 지침, 제품 정보, 고객 관련 자료, 부서별 용어 정의 등 다양한 정보가 존재합니다. 이러한 정보가 적절하게 연결되면 에이전트는 일반적인 지식뿐 아니라 기업의 업무 맥락을 고려해 답변할 수 있습니다.
특히 여러 부서에서 공통으로 사용하는 데이터 정의와 업무 용어를 일관되게 활용하는 데 도움이 될 수 있습니다.
3.3. 절차 메모리(Procedural Memory)
절차 메모리는 업무를 수행하는 방법과 절차를 저장하는 역할을 합니다.
기업 업무는 단순히 결과를 아는 것만으로 완료되지 않습니다. 특정 데이터를 조회하는 방법, 보고서를 생성하는 순서, 시스템을 활용하는 절차 등을 알아야 실제 작업을 수행할 수 있습니다.
원문에 따르면 Gemini 에이전트는 작업 수행에 필요한 스킬을 자체적으로 작성하는 기능도 절차 메모리와 관련해 소개합니다.
이러한 구조는 반복 업무의 실행 방식을 관리하고 재사용하는 데 활용될 수 있습니다.
3.4. 일화 메모리(Episodic Memory)
일화 메모리는 에이전트가 과거에 수행한 작업과 관련된 이력을 기록하는 역할을 합니다.
이전 작업의 결과와 실행 이력을 활용하면 유사한 업무를 수행할 때 참고할 수 있는 맥락이 늘어납니다.
예를 들어 반복적으로 수행하는 데이터 분석 업무에서는 과거에 어떤 작업이 진행됐는지 확인하는 것이 도움이 될 수 있습니다.
다만 과거의 실행 이력이 항상 올바른 판단을 보장하는 것은 아닙니다. 데이터가 변경됐거나 업무 규칙이 달라졌다면 이전 결과를 그대로 적용하기보다 현재 상황을 다시 확인해야 합니다.
3.5. 네 가지 메모리의 차이
네 가지 메모리는 서로 다른 목적을 가집니다.
| 메모리 유형 | 주요 역할 |
| 세션 메모리 | 현재 작업의 맥락과 진행 상황 유지 |
| 의미 메모리 | 문서와 기업 지식을 구조화해 활용 |
| 절차 메모리 | 작업 수행 방법과 스킬 관리 |
| 일화 메모리 | 과거 실행 이력과 경험 기록 |
이처럼 메모리를 구분하면 현재 작업을 이어가는 기능, 기업 지식을 활용하는 기능, 작업 절차를 재사용하는 기능, 과거 실행을 참고하는 기능을 각각 이해할 수 있습니다.
기업 환경에서는 메모리의 활용 범위뿐 아니라 데이터 접근 권한, 보존 정책, 민감 정보 처리 방식도 함께 검토해야 합니다.
4. 기업 시스템 및 데이터 도구 연동
기업용 AI 에이전트의 활용도를 결정하는 중요한 요소 중 하나는 기존 시스템과 얼마나 효과적으로 연결되는가입니다.
Gemini 에이전트는 기업의 다양한 도구와 데이터 플랫폼을 연결해 업무 수행에 필요한 정보를 활용하는 구조를 제시합니다.
4.1. 스킬과 도구의 관리
원문에서는 스킬을 공통 기업 레지스트리에 저장되는 모듈형 프롬프트로 설명합니다. 도구는 별도의 기업 도구 레지스트리를 통해 관리하는 구조입니다.
여기서 스킬은 특정 업무를 수행하는 방법이나 지침에 가깝고, 도구는 실제 시스템과 상호작용하거나 작업을 실행하는 수단으로 이해할 수 있습니다.
예를 들어 특정 형식의 보고서를 작성하는 규칙은 스킬로 관리할 수 있고, 데이터베이스에서 정보를 조회하는 기능은 도구를 통해 제공할 수 있습니다.
이러한 구분은 업무 지침과 실제 실행 기능을 분리해 관리하는 데 도움이 됩니다.
4.2. 주요 연동 대상
원문에서는 다음과 같은 시스템과 데이터 플랫폼을 연동 대상으로 소개합니다.
- Slack
- Jira
- Salesforce
- ServiceNow
- BigQuery
- Snowflake
- 데스크톱 파일
- Model Context Protocol(MCP) 서버
이러한 연결을 통해 에이전트는 협업 도구, 업무 관리 시스템, 고객 관리 시스템, 데이터 분석 플랫폼 등 여러 환경에서 필요한 정보를 활용할 수 있습니다.
특히 MCP(Model Context Protocol)는 AI 애플리케이션이 외부 도구와 데이터에 연결할 때 활용할 수 있는 표준화된 프로토콜입니다. 이를 지원하는 서버와 연동하면 에이전트가 사용할 수 있는 도구와 데이터의 범위를 확장할 수 있습니다.
다만 연동 대상이 소개됐다는 사실만으로 모든 시스템에서 모든 기능이 동일하게 제공된다고 볼 수는 없습니다. 실제 적용 시에는 커넥터 지원 범위와 인증 방식, 권한 설정, 데이터 접근 정책을 확인해야 합니다.
5. 기업 데이터 분석과 데이터 엔지니어링 지원
Gemini 에이전트는 일반적인 사무 업무뿐 아니라 데이터 및 머신러닝 엔지니어링 업무를 지원하는 기능도 소개합니다.
원문에 따르면 데이터 및 ML 엔지니어는 자연어로 원하는 결과를 설명하고, 에이전트는 이를 바탕으로 PySpark 코드를 작성하거나 노트북을 제공하고, 모델 학습과 데이터 파이프라인 문제 해결을 지원할 수 있습니다.
5.1. 자연어 기반 데이터 작업
기존의 데이터 분석 업무에서는 사용자가 SQL이나 Python, PySpark 등 필요한 기술을 직접 활용해야 하는 경우가 많습니다.
자연어 기반 에이전트는 사용자가 원하는 분석 결과를 설명하면 이에 필요한 코드와 실행 절차를 지원하는 방식으로 접근합니다.
예를 들어 다음과 같은 요청을 생각할 수 있습니다.
"지난달 매출 데이터를 기준으로 주요 지표를 분석하고 결과를 정리해 줘."
이 요청은 기능을 설명하기 위한 가상의 예시입니다. 실제 환경에서는 데이터가 저장된 위치, 지표의 정의, 사용자의 접근 권한, 실행 도구의 지원 여부에 따라 수행 가능한 범위가 달라집니다.
이러한 접근의 장점은 사용자가 모든 구현 절차를 처음부터 직접 작성하지 않고도 분석 작업을 시작할 수 있다는 점입니다.
다만 생성된 코드를 실제 운영 환경에 적용하기 전에는 데이터 범위와 계산 로직, 실행 결과를 검증해야 합니다.
5.2. Knowledge Catalog를 통한 데이터 의미 표준화
원문에서는 Knowledge Catalog를 여러 에이전트가 공통으로 활용할 수 있는 비즈니스 정의 관리 기능으로 소개합니다.
기업에서는 같은 데이터라도 부서별로 정의와 해석이 다를 수 있습니다. 예를 들어 매출, 활성 고객, 전환율 등의 지표가 조직마다 다르게 정의되면 AI가 생성한 분석 결과도 일관성을 잃을 수 있습니다.
Knowledge Catalog는 비즈니스 정의를 공통으로 관리해 이러한 문제를 줄이기 위한 기반으로 설명됩니다.
원문은 Bloomberg Media가 Knowledge Catalog를 활용해 데이터 에이전트의 SQL 질의 정확도를 63% 높였다고 소개합니다.
다만 이 수치는 원문에서 제시한 특정 사례에 해당하며, 모든 기업이나 데이터 환경에서 동일한 개선 효과가 발생한다는 의미는 아닙니다. 실제 효과를 판단하려면 평가 기준과 비교 조건, 데이터 구성 등을 함께 확인해야 합니다.
5.3. Smart Storage와 비정형 데이터 활용
기업 데이터는 데이터베이스의 정형 데이터만으로 구성되지 않습니다. 문서, 파일, 보고서 등 구조화되지 않은 형태의 데이터도 업무에 중요한 역할을 합니다.
원문은 기업 데이터의 90%가 비정형 데이터라는 Google의 설명을 인용하며, Smart Storage가 비정형 객체를 기존 위치에서 보강하는 기능을 제공한다고 소개합니다.
이러한 접근은 데이터를 별도의 구조로 모두 옮기지 않고도 비정형 데이터의 활용도를 높이려는 방향으로 이해할 수 있습니다.
다만 실제로 어떤 유형의 파일을 지원하는지, 데이터의 구조화와 검색이 어떤 방식으로 이루어지는지는 구체적인 구현과 서비스 문서를 통해 확인해야 합니다.
5.4. Borderless Lakehouse를 통한 데이터 접근
원문에서는 Borderless Lakehouse가 Amazon S3와 Azure Data Lake에 저장된 데이터를 조회하는 기능을 소개합니다.
기업이 여러 클라우드 환경을 함께 사용한다면 데이터가 서로 다른 저장소에 분산될 수 있습니다. 이때 데이터를 한곳으로 모두 이동하지 않고 필요한 데이터를 조회할 수 있다면 데이터 통합과 분석 과정의 부담을 줄일 가능성이 있습니다.
원문은 이 기능과 관련해 변동형 데이터 송신 비용이 발생하지 않는다는 점도 언급합니다. 다만 실제 비용 조건은 서비스 구성과 사용 방식, 적용 정책에 따라 확인할 필요가 있습니다.
6. Coworker Agent: 기업 내 AI 동료
Gemini 에이전트에서 주목할 부분 중 하나는 Coworker Agent, 즉 업무 역할을 가진 지속형 에이전트입니다.
일반적인 AI 도구가 사용자의 요청에 따라 일시적으로 작업을 수행하는 데 초점을 맞춘다면, Coworker Agent는 특정 역할을 부여받은 지속적인 업무 파트너 형태로 설계됐습니다.
6.1. 독립적인 업무 계정과 정체성
원문에 따르면 Google Workspace 환경에서 Coworker Agent는 자체 이메일 주소와 캘린더, Drive, 디렉터리 항목을 가질 수 있습니다.
이를 통해 에이전트를 단순한 대화형 도구가 아니라 조직 안에서 식별 가능한 업무 주체로 관리하는 접근을 보여줍니다.
또한 동료가 Chat이나 Docs에서 에이전트를 멘션해 업무를 요청할 수 있으며, 에이전트가 수행한 수정 사항은 자체 이름으로 버전 기록에 표시될 수 있다고 설명합니다.
이러한 구조는 업무 결과가 어떤 에이전트에 의해 생성됐는지 확인하고, 사람의 작업과 구분하는 데 도움이 될 수 있습니다.
6.2. Google Workspace와의 연계
원문에서는 Coworker Agent가 Gmail, Docs, Sheets, Slides, Chat, Calendar 등에서 작업을 지원한다고 소개합니다.
또한 업무 중 위임할 수 있는 작업을 발견하면 사용자가 한 번의 클릭으로 해당 작업을 위임할 수 있는 기능도 언급합니다.
이러한 방식은 AI를 별도의 애플리케이션에서만 사용하는 대신, 기존 업무 흐름에 자연스럽게 연결하려는 방향입니다.
다만 에이전트가 모든 업무를 자율적으로 처리할 수 있다는 의미는 아닙니다. 실제 실행 범위는 부여된 권한과 시스템 설정, 업무별 정책에 따라 달라집니다.
6.3. 공유된 정보만 접근하는 구조
원문은 Coworker Agent가 자신에게 공유된 정보만 볼 수 있다고 설명합니다.
기업 환경에서는 업무 자동화의 편의성만큼이나 정보 접근 통제가 중요합니다. AI가 업무에 필요한 데이터를 활용하더라도 사용자나 에이전트에게 허용되지 않은 정보까지 접근해서는 안 되기 때문입니다.
따라서 독립적인 에이전트 계정과 권한 관리 기능은 업무 자동화뿐 아니라 책임 추적과 정보 보호 측면에서도 중요한 요소입니다.
7. 기업 환경을 위한 보안과 거버넌스
기업에서 AI 에이전트를 도입할 때는 작업 수행 능력만으로 충분하지 않습니다. 어떤 에이전트가 어떤 데이터에 접근할 수 있는지, 어떤 작업을 수행했는지, 어떤 작업은 금지해야 하는지 명확하게 관리해야 합니다.
Google Cloud는 Gemini 에이전트의 거버넌스를 네 가지 질문으로 설명합니다.
- 누가 작업을 수행하는가?
- 무엇을 수행할 수 있는가?
- 실제로 무엇을 수행했는가?
- 무엇에 절대 접근하거나 실행해서는 안 되는가?
이를 바탕으로 원문에서는 다음과 같은 보안 및 관리 기능을 소개합니다.
7.1. 에이전트별 식별과 최소 권한
각 에이전트에는 암호학적으로 검증된 정체성이 부여되며, 최소 권한 원칙에 따라 필요한 권한만 제공하는 구조를 제시합니다.
최소 권한 원칙은 시스템이나 사용자에게 업무 수행에 필요한 범위의 권한만 부여하는 보안 원칙입니다.
예를 들어 보고서를 조회해야 하는 에이전트라면 반드시 데이터 수정이나 삭제 권한까지 가질 필요는 없습니다.
이처럼 권한을 분리하면 에이전트가 실수하거나 예상하지 못한 작업을 수행했을 때 발생할 수 있는 위험을 줄이는 데 도움이 됩니다.
7.2. 역할 기반 접근 제어와 외부 시스템 연계
원문에서는 역할 기반 접근 제어와 OAuth 등의 표준을 활용해 외부 시스템의 권한을 연결하는 구조를 소개합니다.
역할 기반 접근 제어(RBAC)는 사용자의 역할에 따라 접근 가능한 데이터와 기능을 구분하는 방식입니다.
이를 에이전트 환경에 적용하면 조직의 업무 역할과 시스템 권한을 바탕으로 에이전트의 접근 범위를 관리할 수 있습니다.
다만 실제 권한 정책은 연결된 외부 시스템과 기업의 보안 설정에 따라 달라질 수 있으므로, 에이전트 자체의 권한뿐 아니라 연동 대상 시스템의 권한도 함께 검토해야 합니다.
7.3. 에이전트 단위의 감사 로그
원문은 에이전트가 수행한 작업을 사람의 계정과 구분해 에이전트 자체에 연결된 기록으로 관리하는 구조를 설명합니다.
이러한 방식은 자동화된 작업의 실행 주체를 식별하고, 문제가 발생했을 때 어떤 에이전트가 어떤 작업을 수행했는지 추적하는 데 도움이 될 수 있습니다.
특히 데이터 변경이나 외부 시스템 연동이 포함된 업무에서는 실행 이력의 확보가 중요합니다.
7.4. Agent Sandbox와 Agent Gateway
원문에 따르면 에이전트는 Agent Sandbox에서 실행되며, 네트워크 트래픽은 Agent Gateway를 거치는 구조로 설계됩니다.
Agent Gateway는 모든 에이전트에 공통 정책을 적용하는 AI 네트워크 방화벽으로 소개됩니다.
이러한 구조는 에이전트별로 서로 다른 보안 규칙을 적용하는 데서 발생할 수 있는 관리 부담을 줄이고, 네트워크 접근 정책을 일관되게 적용하는 데 목적이 있습니다.
다만 보안 기능이 제공된다는 사실만으로 모든 위험이 자동으로 제거되는 것은 아닙니다. 기업은 실제 데이터 흐름과 권한 설정, 로그 보존, 정책 위반 대응 절차를 함께 검토해야 합니다.
8. AI 에이전트의 비용 관리와 모델 라우팅
AI 에이전트가 복잡한 작업을 수행하고 여러 모델과 도구를 호출하면 사용량과 비용이 증가할 수 있습니다.
특히 작업이 장시간 실행되거나 하위 에이전트가 여러 개 생성되는 환경에서는 비용을 예측하고 통제할 수 있는 기능이 중요합니다.
Google Cloud는 이를 위해 세 가지 주요 비용 관리 방식을 소개합니다.
8.1. 멀티 모델 오케스트레이션
작업의 성격에 따라 적합한 모델을 선택하는 방식입니다.
복잡한 추론이 필요한 작업에는 추론 성능을 고려한 모델을 사용하고, 빠른 응답이나 대량 처리가 필요한 작업에는 비용과 속도 측면에서 적합한 모델을 선택하는 식입니다.
원문은 Gemini와 Claude 모델을 활용하는 구조를 소개합니다.
이러한 방식은 모든 작업을 가장 높은 비용의 모델로 처리하지 않고, 작업별 요구사항에 맞춰 모델을 선택할 수 있다는 점에서 의미가 있습니다.
8.2. Smart Routing
Smart Routing은 작업을 분석해 해당 작업을 수행할 수 있는 모델 가운데 비용 효율적인 선택지를 활용하는 기능으로 소개됩니다.
예를 들어 단순한 분류 작업과 복잡한 추론 작업에 동일한 모델을 적용하면 필요 이상의 비용이 발생할 수 있습니다.
모델 라우팅을 활용하면 작업의 난이도와 요구 성능에 따라 적합한 모델을 선택해 비용을 최적화할 가능성이 있습니다.
다만 저비용 모델을 선택하는 것만으로 비용과 성능이 모두 개선된다고 단정할 수는 없습니다. 실제 결과는 모델별 성능과 작업 특성, 호출 횟수 등에 따라 달라집니다.
8.3. 프로젝트별 하드 비용 한도
원문에서는 Cloud Billing Console에서 프로젝트별 비용 상한을 설정할 수 있다고 설명합니다.
설정한 한도에 도달하면 해당 프로젝트의 에이전트가 일시 중지되고, 관리자가 다시 실행할 때까지 작업을 멈추는 구조입니다.
이 기능은 장시간 실행되는 작업이나 예상보다 많은 호출이 발생하는 상황에서 비용이 계속 증가하는 것을 방지하는 데 도움이 될 수 있습니다.
또한 원문은 Google의 TPU 8i 시스템이 이전 세대보다 가격 대비 성능이 80% 향상됐다는 Google 측의 설명도 소개합니다.
이 수치는 원문에서 인용한 내용이며, 실제 비용 절감 효과는 워크로드와 사용 환경에 따라 달라질 수 있습니다.
9. 기존 AI 업무 도구와의 차이
원문은 Google Cloud Gemini 에이전트를 Microsoft 365 Copilot, OpenAI의 업무용 ChatGPT, Amazon Quick 등과 비교합니다.
다만 비교표에 포함된 제품별 정보의 공개 수준은 서로 다르며, 모든 기능을 동일한 조건에서 평가한 벤치마크 결과가 제시된 것은 아닙니다. 따라서 아래 내용은 원문에서 강조한 기능적 차이를 중심으로 이해하는 것이 적절합니다.
9.1. 통합된 업무 실행 환경
Gemini 에이전트는 질문 응답, 지식 업무, 콘텐츠 생성, 코드 작성 등을 하나의 에이전트와 API로 통합하는 방향을 강조합니다.
여러 도구를 따로 선택해 사용하는 대신 하나의 실행 환경에서 다양한 업무를 처리하려는 접근입니다.
9.2. 지속적인 에이전트 실행과 독립적인 정체성
원문에서 강조하는 또 다른 특징은 장시간 작업을 클라우드에서 이어서 수행할 수 있다는 점과 Coworker Agent에 독립적인 Workspace 정체성을 부여할 수 있다는 점입니다.
이러한 기능은 에이전트를 일회성 응답 도구가 아닌 지속적인 업무 실행 주체로 활용하려는 기업에 의미가 있습니다.
9.3. 보안과 비용 통제를 함께 고려한 설계
에이전트의 실행 능력이 높아질수록 권한 관리와 감사 기록, 비용 통제의 중요성도 커집니다.
Gemini 에이전트는 에이전트별 식별과 최소 권한, 공통 네트워크 정책, 프로젝트별 비용 상한을 주요 기능으로 소개합니다.
이러한 요소는 실제 기업 환경에서 AI 에이전트를 운영하기 위한 관리 기반이라는 점에서 주목할 만합니다.
다만 기능 목록만으로 특정 제품이 다른 제품보다 우수하다고 결론 내리기는 어렵습니다. 실제 비교를 위해서는 업무별 정확도, 보안 요구사항, 기존 시스템과의 호환성, 총운영비용 등을 동일한 조건에서 평가해야 합니다.
10. 기업에서 Gemini 에이전트를 활용할 때 고려할 사항
Gemini 에이전트는 여러 업무를 통합적으로 지원하는 구조를 제시하지만, 기업에서 실제로 도입하려면 기능 소개 외에도 검토해야 할 요소가 있습니다.
10.1. 업무 범위와 자동화 수준 정의
먼저 어떤 업무를 에이전트에 맡길 것인지 구체적으로 정의해야 합니다.
반복적인 문서 정리, 데이터 조회, 분석 보고서 작성처럼 결과를 확인하기 쉬운 업무부터 검토하면 자동화의 효과를 평가하기 수월합니다.
반면 중요한 데이터 변경이나 외부 시스템에 영향을 미치는 작업은 실행 전에 사람의 검토를 거치도록 설계하는 것이 적절할 수 있습니다.
10.2. 데이터 품질과 업무 정의 표준화
AI가 데이터를 정확하게 분석하려면 데이터 자체의 품질뿐 아니라 지표와 업무 용어의 정의도 일관돼야 합니다.
같은 지표를 부서마다 다르게 계산한다면 AI가 코드를 올바르게 작성하더라도 결과가 조직의 기대와 다를 수 있습니다.
따라서 데이터 카탈로그와 공통 지표 정의, 데이터 소유자, 접근 권한 등을 사전에 정리하는 작업이 중요합니다.
10.3. 권한과 감사 정책 검토
에이전트가 접근할 수 있는 데이터와 실행할 수 있는 작업을 명확히 구분해야 합니다.
특히 이메일, 고객 정보, 업무 문서, 데이터베이스 등 여러 시스템을 연결하는 경우에는 각 시스템의 권한과 에이전트의 권한이 어떻게 적용되는지 확인해야 합니다.
실행 기록을 검토하는 절차와 오류 발생 시 대응 방식도 함께 마련할 필요가 있습니다.
10.4. 비용과 성능의 균형 평가
장시간 실행과 다중 모델 호출은 업무 효율을 높일 수 있지만, 동시에 비용 관리의 복잡성을 높일 수 있습니다.
따라서 프로젝트별 비용 한도를 설정하고, 실제 작업별 호출량과 처리 시간을 측정하며, 모델 선택에 따른 결과 품질을 비교하는 과정이 필요합니다.
비용만 낮추는 것이 아니라 정확도와 안정성을 함께 고려해야 실질적인 업무 효율 개선으로 이어질 수 있습니다.
10.5. 도입 전 검증 항목 확인
원문은 Gemini 에이전트의 핵심 방향과 주요 기능을 소개하지만, 구체적인 벤치마크와 가격, 일반 제공 일정은 제시하지 않았다고 설명합니다.
따라서 도입을 검토하는 기업은 다음 항목을 확인하는 것이 좋습니다.
- 실제 사용 가능한 기능과 지원 모델
- 기존 업무 시스템과의 연결 범위
- 데이터 접근 권한과 보안 정책
- 실행 이력 및 감사 기능의 세부 범위
- 장시간 작업의 실행 및 중단 조건
- 사용량 기반 비용과 프로젝트별 비용 한도
- 실제 업무를 기준으로 한 정확도와 처리 시간
이러한 검증 과정을 거치면 기능 소개에만 의존하지 않고 조직의 업무 환경에 적합한지 판단할 수 있습니다.
Google Cloud Gemini 에이전트의 핵심은 AI 모델 자체보다 모델과 데이터, 도구, 업무 맥락을 하나의 실행 환경으로 연결하는 데 있습니다.
사용자가 목표를 전달하면 에이전트가 작업을 계획하고, 필요한 모델과 도구를 선택하며, 여러 단계를 연결해 결과물을 만드는 구조입니다.
여기에 네 가지 메모리 유형과 멀티 에이전트 오케스트레이션을 결합해 장시간 작업과 반복 업무를 지원하고, Coworker Agent를 통해 조직의 업무 흐름에 AI를 연결하려는 방향도 제시합니다.
기업 데이터 분석 측면에서는 자연어 기반 코드 작성과 데이터 파이프라인 지원, 공통 비즈니스 정의 활용, 여러 저장소에 분산된 데이터 접근 등이 주요 특징입니다.
또한 에이전트별 정체성, 최소 권한, 감사 기록, 네트워크 정책, 프로젝트별 비용 한도를 통해 자동화 기능과 운영 통제를 함께 고려합니다.
다만 이러한 기능이 실제로 어느 정도의 생산성 향상과 비용 절감으로 이어질지는 업무 유형과 데이터 품질, 시스템 구성, 운영 정책에 따라 달라집니다. 원문에서 구체적인 벤치마크와 가격, 일반 제공 일정이 확정적으로 제시되지 않았다는 점도 고려해야 합니다.
결국 기업 AI의 경쟁력은 더 많은 모델을 사용하는 데서만 결정되지 않습니다. 필요한 데이터를 안전하게 연결하고, 업무에 적합한 모델과 도구를 선택하며, 실행 결과를 검증하고 비용을 통제할 수 있는 운영 체계를 갖추는 것이 중요합니다.
Google Cloud Gemini 에이전트는 이러한 방향을 하나의 통합된 에이전트 환경으로 구현하려는 시도라는 점에서 주목할 만합니다. 앞으로 실제 업무 환경에서의 성능과 운영 비용, 보안 및 시스템 연동 범위가 구체화된다면 기업의 AI 에이전트 도입 전략을 검토하는 데 중요한 기준이 될 수 있습니다.
Google Cloud Launches Gemini Agent, One Universal Agent for Enterprise Work
Google Cloud’s Gemini agent is one enterprise agent routing work across Gemini and Claude models, with spend caps.
www.marktechpost.com
'인공지능' 카테고리의 다른 글
| NVIDIA PivotOPD: AI 에이전트의 치명적인 실수를 예방하고 복구하는 학습 기술 (0) | 2026.10.10 |
|---|---|
| tinyjs: JavaScript로 가벼운 네이티브 데스크톱 애플리케이션 개발하기 (0) | 2026.10.10 |
| Google Research RRSI: AI 에이전트의 자기 개선을 위한 핵심 원리와 평가 방법 (0) | 2026.10.10 |
| 코딩 에이전트 벤치마크: Ralph Loop 기반 AI 코딩 성능 평가와 활용 방향 (0) | 2026.10.10 |
| Graph RAG와 일반 RAG 비교: 환각 벤치마크로 살펴보는 검색 증강 생성의 정확도와 한계 (0) | 2026.10.10 |


